Hard Negatives, Hard Lessons:用 LLM 重标检索训练中的假负样本
Hard Negatives, Hard Lessons(Findings of EMNLP 2025)将 BGE 的 15 个检索训练数据集裁剪到 7 个,训练对数从约 160 万降到约 68 万。数据量缩小约 2.35 倍,E5 base 在 14 个 BEIR 数据集上的平均 nDCG@10 却提升了约 1 个点。
裁剪后的数据仍有标签问题。有些段落能回答查询,却被当成难负样本用于训练。论文提出的 RLHN(ReLabeling Hard Negatives)用两级 LLM 找出这些段落,将它们改标为正样本。相对保留原始标签的训练数据,重标让 E5 base 和 Qwen2.5 7B 在 BEIR 上分别提升约 0.7 和 1.4 个点。
难负样本中的错误监督
检索模型的训练实例通常由查询、正样本和一组难负样本构成。难负样本通常从检索模型的高排名结果中选取,与查询较为相似,但在训练时被视为不相关,用来帮助模型区分相关与不相关的段落。
问题出在许多检索数据集采用稀疏标注。标注者只看过候选池里很少的一部分文档,未被判断过的文档不等于不相关。挖掘范围扩到整个语料后,模型会找到一些没有标注但确实相关的段落。
论文用 HotpotQA 中的一条数据说明这个问题。查询问的是"哪个公园包含 Wild Beast 和一个占地 20 英亩的水上乐园"。
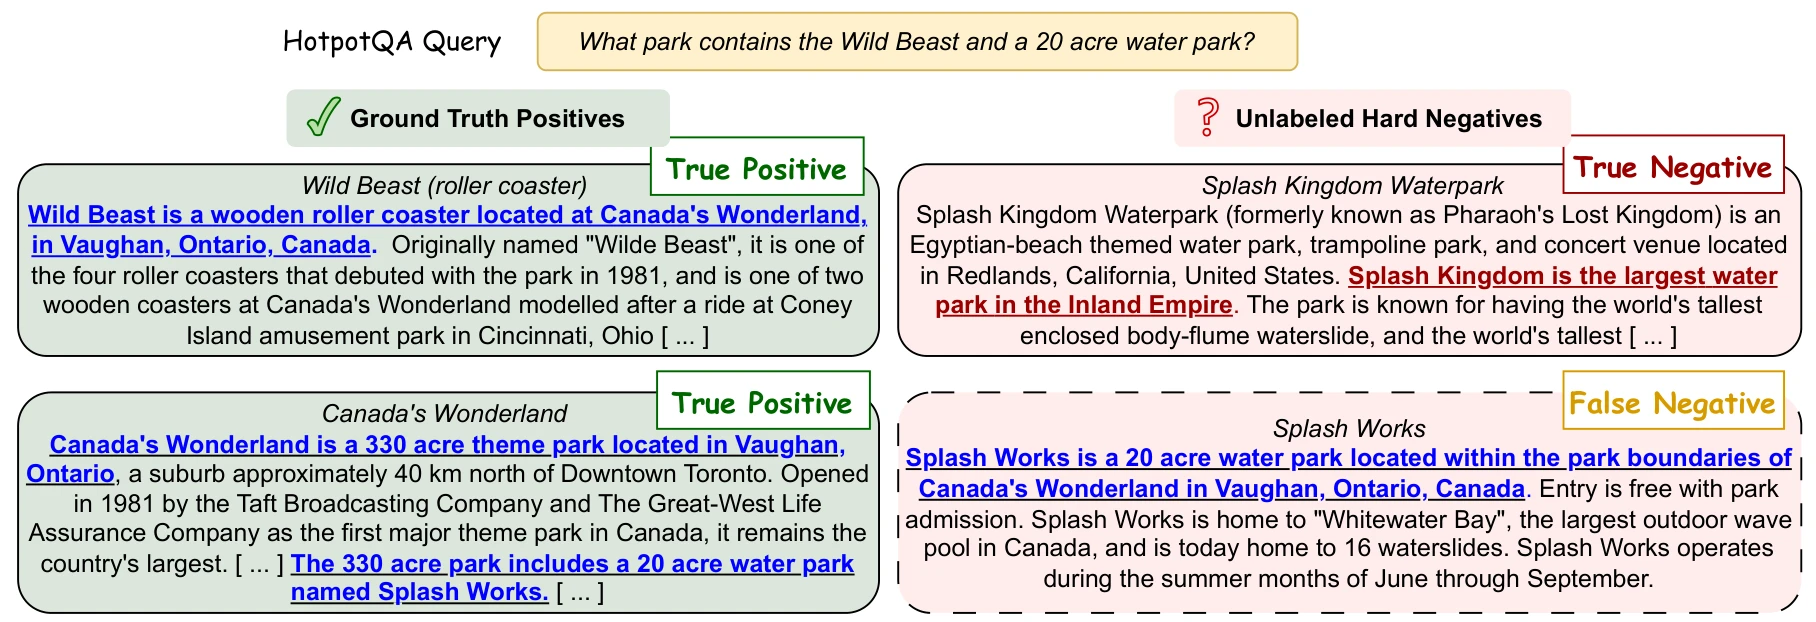
图左是原始数据标注的两个正样本,分别介绍 Wild Beast 过山车和 Canada’s Wonderland。右上角的 Splash Kingdom Waterpark 位于加利福尼亚,与查询无关。右下角的 Splash Works 则明确写着自己位于 Canada’s Wonderland 内、占地 20 英亩。图中蓝色文字标出了回答查询的证据。Splash Works 能提供相关证据,却被训练数据当成负样本,这类标签会让对比学习压低相关段落的分数。
假负样本也不总是这样清楚。人工分析里还看到几种情况。有的原始正样本本身不对,有的查询能对应多个段落,还有的候选只回答了问题的一部分。这里不只是标签噪声,还要判断相关程度,并处理查询自身的歧义。
RLHN 的级联重标
数据集裁剪能缩小清洗范围,但无法判断具体哪篇文档被标错。RLHN 在保留的 7 个数据集中,对其中 6 个进行实例级重标。ArguAna 要检索反方论点,论文保留了它的原始标签。
RLHN 在单次 API 调用中,把查询、已有正样本和最多 25 个难负样本一起交给 LLM。模型判断候选与查询的相关性,并与已有正样本比较。GPT 4o mini 扫描待清洗的实例,初筛可能含有假负样本的数据。只有第一级命中的实例才送给 GPT 4o 复核。

图左是一条训练实例,包含查询、已有正样本和一组难负样本。GPT 4o mini 只把可能含有假负样本的实例送入第二级。若第一级没有发现问题,该实例不再复核。GPT 4o 的判断用于划分候选:被判为相关的段落转入正样本集合,其余候选继续作为难负样本。这一步改变的是训练标签。
按论文采用的 2025 年 5 月价格,第一级费用估算约为 300 美元,第二级约为 3000 美元。论文将它们作为最高费用估算,使用实际输入 token 数,并按平均每次输出 2048 个 token 计算。级联可以减少较贵模型需要读取的数据。论文比较了三种处理检测结果的方式:
- 删除整条训练实例,包括原有正样本和其余难负样本。
- 只从难负样本集合中删除被误标的候选。
- 将被误标的候选加入正样本集合,保留实例中的其余难负样本。
第三种就是 RLHN。它把检测到的相关段落作为正样本保留下来,同一查询可以对应多个正样本。若一个实例中检测出的假负样本超过 7 个,论文会丢弃整条实例。作者认为这类查询可能存在歧义,不适合用于训练。
数据集裁剪结果
开头的 2.35 倍数据缩减来自重标之前的留一实验。论文逐次从 BGE 的 15 个检索训练数据集中移除一个,用剩余数据微调 E5 base,观察它对 BEIR 评测的影响,再结合各单项任务的表现选择保留的数据集。

每根柱子表示移除横轴对应数据集后的平均分。完整训练集的基线是 0.519,柱子高于基线意味着移除该数据集后效果提高,低于基线则意味着效果下降。最终保留 7 个数据集的组合达到 0.529,对应图中的 “7 Pruned” 参考线。这条线比较的是约 68 万对数据与完整的约 160 万对数据,是本文开头约 1 个点增益的来源。
ELI5 是其中一个例子:单独移除它,平均 nDCG@10 从 0.519 升到 0.525。最终保留的是 FEVER、HotpotQA、ArguAna、FiQA 2018、MS MARCO Passage、NQ 和 SCIDOCS RR。这个选择结合了平均分与单项任务表现,不能简化成把所有平均贡献为负的数据集删掉。
论文首页脚注写明,裁剪后保留原始训练对的约 42.5%。约 160 万除以约 68 万得到约 2.35,换算成移除比例就是约 57.5%。这些数字描述的是数据集裁剪,与重标时检测出的假负样本比例不同。
检索与重排结果
重标实验固定模型和训练参数,以裁剪后、保留原始标签的数据为基线。E5 base 和 Qwen2.5 7B 在 BEIR 上的平均 nDCG@10 分别提升约 0.7 和 1.4 个点。这组比较检验的是修改标签的效果,与前面的数据集裁剪不同。两组 BEIR 评测分别覆盖 16 和 14 个数据集,增益不能直接相加。
三种处理方式的差别在于保留了多少监督信息。删除整条实例会连同原有正样本一起丢掉,只删除假负样本则不再利用这些相关段落。重标把它们加入正样本集合,让模型学习同一查询与更多相关段落的对应关系。以 E5 base 为例,三种方式在 BEIR 上的平均分依次为 0.506、0.511 和 0.515,支持了保留并修正这些标签的做法。难负样本数量的消融也显示,重标后增加难负样本仍能改善效果。
收益也出现在训练未覆盖的领域。零样本 AIR BENCH 上,E5 base 和 Qwen2.5 7B 分别提升约 1.8 和 1.7 个点,支持了数据修正有助于跨领域泛化的判断。同一份重标数据用于 Qwen2.5 3B 重排模型时,BEIR 平均分提升约 0.8 个点,说明这份数据对检索器和重排器都有用。
不过,直接修正标签并非所有设置下效果最好的方案。E5 base 的 cross encoder 蒸馏在 BEIR 上与 RLHN 接近,在 AIR BENCH 上达到 0.401,高于 RLHN 的 0.386。如果目标是提升这个设置下的检索分数,蒸馏仍是很强的基线。RLHN 则提供了一份可以继续用于不同模型训练的重标数据。
标注可靠性与适用范围
训练效果改善并不意味着标签已经完全正确。在 670 个查询与难负样本对的人工验证中,GPT 4o mini 和 GPT 4o 与人工判断的 Cohen’s kappa 分别为 0.320 和 0.390。更贵的模型与人工更一致,但定性分析仍发现了误判。抽查样本又来自 RLHN 已经命中的实例,无法据此判断完整训练集上还有多少假负样本被漏掉。
这也说明相关性判定需要结合具体任务。RLHN 以候选能否回答查询为标准,并参考已有正样本。ArguAna 要检索反方论点,不能直接套用这套标准,因此保留了原始标签。已有正样本错误或查询存在歧义时,重标也可能出错。方法在英文段落检索上取得的结果,还需要在更大规模数据、多语言和长文档任务上验证。
小结
数据集裁剪说明,训练对数更多不一定带来更好的检索效果。RLHN 则进一步表明,已经挖出的难负样本中有一部分值得作为正样本保留。前者筛选数据源,后者修正实例标签,两项实验共同支持了改善训练数据质量的价值。它们并没有证明所有被裁掉的数据都因假负样本而有害,也没有消除 LLM 判断本身的误差。